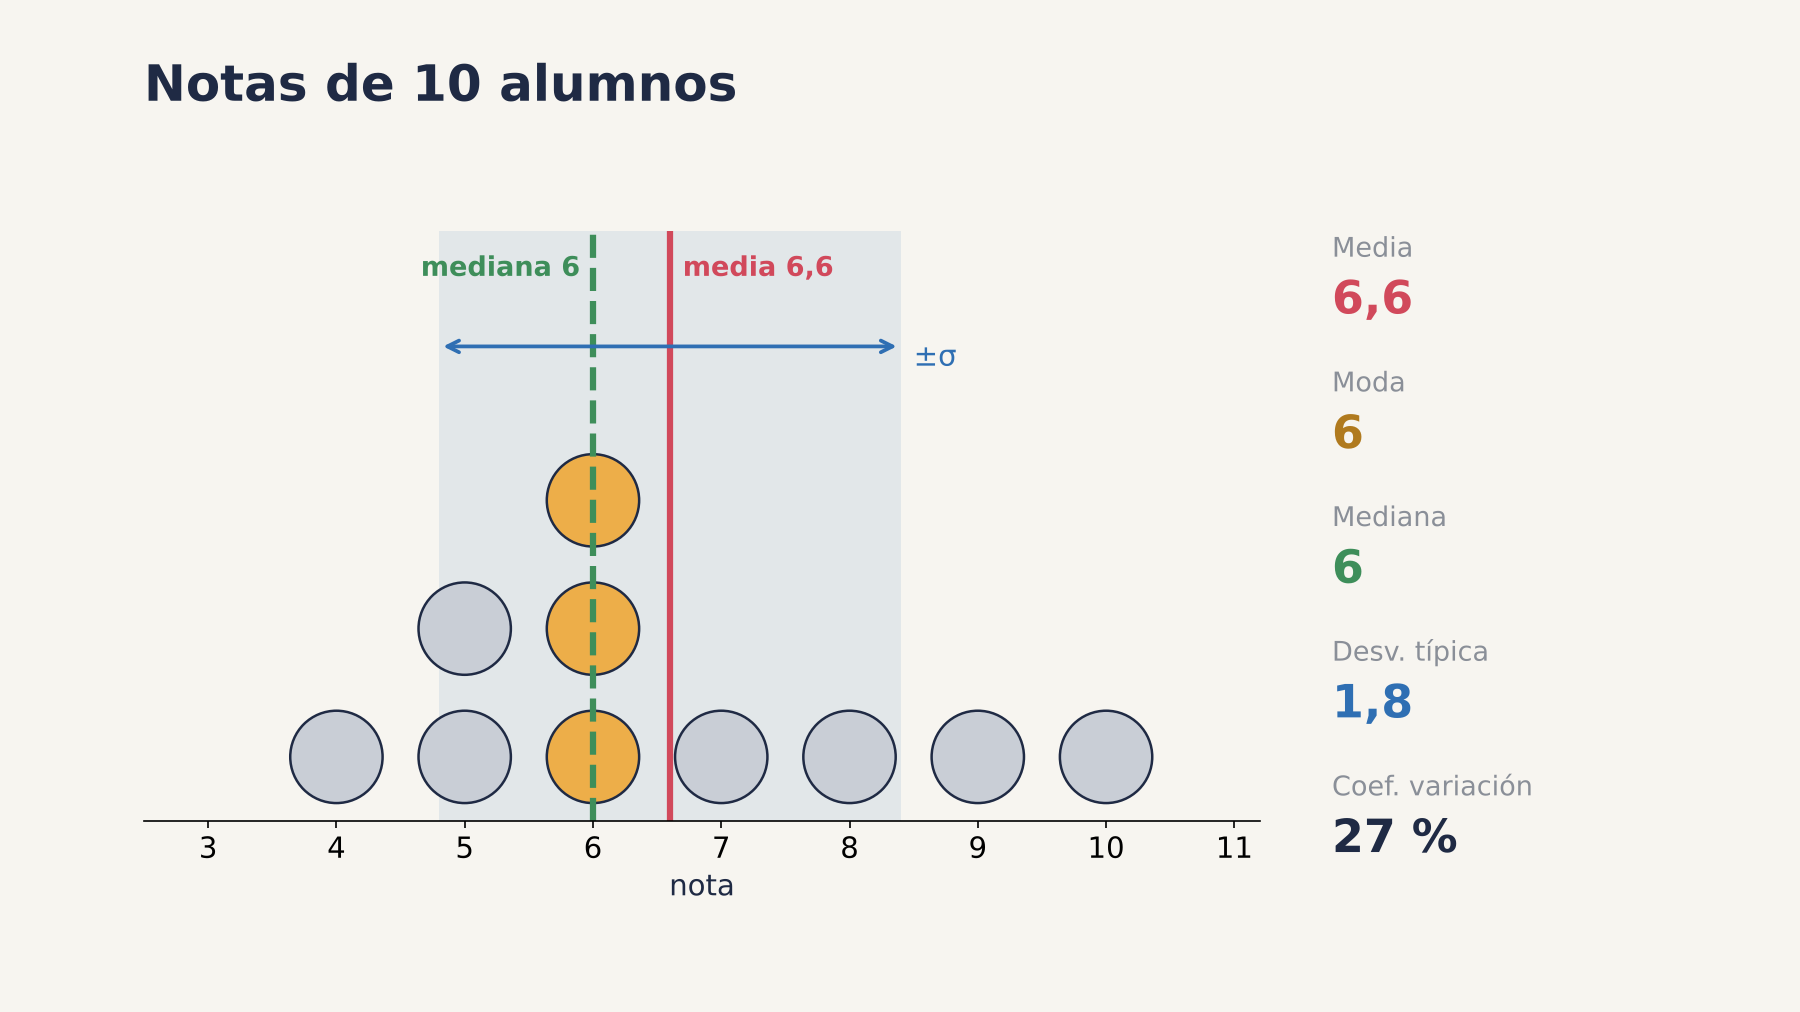
Cuando tenemos muchos datos, necesitamos unos pocos números que los resuman. Las medidas de centralización (media, moda y mediana) indican alrededor de qué valor se agrupan los datos, y las medidas de dispersión (rango, varianza y desviación típica) indican cuánto se alejan de ese centro. Ejemplo: notas de 10 alumnos: 4, 5, 5, 6, 6, 6, 7, 8, 9, 10.
Media aritmética
Es la suma de todos los valores dividida entre el número de datos: x̄ = Σxi / n. En nuestro ejemplo, x̄ = 66 / 10 = 6,6. Es la medida más usada, pero tiene un punto débil: es muy sensible a los valores extremos. Si un alumno saca un 0, la media baja aunque el resto del grupo no haya cambiado.
Moda
Es el valor que más se repite. Aquí es el 6, que aparece tres veces. Es la única medida de centralización que sirve también para variables cualitativas, como el color favorito.
Mediana
Es el valor central cuando los datos están ordenados: deja la mitad por debajo y la mitad por encima. Si el número de datos es par, se hace la media de los dos centrales. Con 10 datos, los centrales son el 5.º y el 6.º (6 y 6), así que la mediana es 6. A diferencia de la media, apenas le afectan los valores extremos; por eso se usa, por ejemplo, para hablar del salario «típico» de un país.
👉Consulta nuestros niveles:
Varianza y desviación típica
La varianza es la media de los cuadrados de las desviaciones respecto de la media: σ2 = Σ(xi − x̄)2 / n. Al elevar al cuadrado evitamos que las desviaciones positivas y negativas se anulen. En el ejemplo, la suma de los cuadrados es 32,4, de modo que σ2 = 3,24.
Como la varianza está en unidades al cuadrado, usamos su raíz: la desviación típica, σ = √3,24 = 1,8 puntos. Nos dice que, en promedio, las notas se separan unos 1,8 puntos de la media. Cuanto mayor es, más dispersos están los datos.
Para comparar grupos: el coeficiente de variación
Si dos grupos tienen medias distintas, la desviación típica sola puede engañar. El coeficiente de variación, CV = σ / x̄, mide la dispersión relativa. Aquí, CV = 1,8 / 6,6 ≈ 27 %. El grupo con menor CV es el más homogéneo.
👉Consulta nuestras academias:
Errores frecuentes
- Olvidar ordenar los datos antes de calcular la mediana.
- Confundir σ (se divide entre n) con la desviación típica muestral, s (se divide entre n − 1). En la calculadora aparecen como σx y sx.


Deja una respuesta